KV Cache trong AI: Vì sao ổ cứng HDD có thể giúp tối ưu hiệu suất và chi phí GPU?
 14-10-2026, 10:06 pm
 7
Khi trí tuệ nhân tạo (AI) chuyển từ giai đoạn huấn luyện mô hình sang vận hành các ứng dụng thực tế, việc tối ưu tài nguyên GPU và chi phí hạ tầng ngày càng trở nên quan trọng. Một trong những yếu tố ảnh hưởng trực tiếp đến hiệu quả AI Inference là KV Cache – cơ chế giúp mô hình tái sử dụng dữ liệu đã xử lý thay vì phải tính toán lại. Theo phân tích và thử nghiệm của Western Digital, ổ cứng HDD có thể đóng vai trò quan trọng trong kiến trúc KV Cache phân tầng, giúp mở rộng dung lượng lưu trữ và nâng cao hiệu quả sử dụng GPU.
KV Cache là gì và vì sao quan trọng đối với AI?
Trong các mô hình ngôn ngữ lớn (LLM), người dùng thường không chỉ đưa ra một câu hỏi rồi kết thúc tương tác. Thay vào đó, họ tiếp tục đặt câu hỏi bổ sung, yêu cầu giải thích hoặc điều chỉnh kết quả dựa trên nội dung trước đó.
Để tạo ra câu trả lời phù hợp, mô hình AI cần sử dụng thông tin ngữ cảnh từ những phần đã xử lý.
Nếu không có cơ chế lưu trữ dữ liệu trung gian, hệ thống có thể phải thực hiện lại những phép tính liên quan đến ngữ cảnh trước đó, làm tăng thời gian xử lý và tiêu tốn tài nguyên GPU.
KV Cache (Key-Value Cache) giúp giải quyết vấn đề này bằng cách lưu trữ các biểu diễn Key và Value đã được tính toán trong cơ chế attention của mô hình.
Nhờ đó, AI có thể tái sử dụng kết quả tính toán khi xử lý các token tiếp theo, thay vì liên tục tính toán lại toàn bộ ngữ cảnh.
Điều này đặc biệt quan trọng đối với các ứng dụng AI có hội thoại dài, nhiều yêu cầu đồng thời hoặc quy trình xử lý phức tạp.
KV Cache có thể cải thiện hiệu suất AI như thế nào?
Trong bài phân tích của Western Digital, tác giả dẫn lại một phép đo hiệu năng từ Hugging Face trên GPU NVIDIA T4.
Kết quả cho thấy:
-
Không sử dụng KV Cache: Tác vụ mất khoảng 61 giây.
-
Có sử dụng KV Cache: Thời gian giảm xuống còn khoảng 11,7 giây.
-
Mức cải thiện thông lượng được báo cáo: Khoảng 5,21 lần.
Sự khác biệt này cho thấy khả năng tái sử dụng kết quả tính toán có thể tác động đáng kể đến hiệu quả xử lý của GPU.
Tuy nhiên, đây là kết quả của một phép đo cụ thể, không có nghĩa mọi ứng dụng AI đều đạt mức tăng hiệu suất tương tự.
Đối với doanh nghiệp vận hành hệ thống AI, việc giảm tính toán lặp lại có thể mang đến hai lợi ích:
Giảm chi phí trực tiếp: GPU dành ít thời gian hơn cho những phép tính đã được thực hiện.
Tăng hiệu quả khai thác tài nguyên: GPU có thêm thời gian để xử lý những yêu cầu mới, thay vì lặp lại công việc cũ.
Khi AI được triển khai trên quy mô lớn, những cải thiện này có thể ảnh hưởng đáng kể đến chi phí vận hành.
Cache Hit Rate – Chỉ số quan trọng trong hệ thống AI Inference
KV Cache chỉ phát huy hiệu quả khi dữ liệu cần sử dụng vẫn còn trong bộ nhớ đệm và có thể truy xuất.
Đây là lý do Cache Hit Rate, hay tỷ lệ truy xuất thành công từ bộ nhớ đệm, trở thành một chỉ số quan trọng.
Cache Hit xảy ra khi hệ thống tìm thấy dữ liệu đã được lưu trong cache và có thể sử dụng lại.
Ngược lại, Cache Miss xảy ra khi dữ liệu cần thiết không có trong cache, khiến hệ thống phải tính toán lại hoặc tìm phương án xử lý khác.
Ví dụ, trong phép đo được Western Digital đề cập, việc không tái sử dụng được cache có thể khiến một tác vụ mất 61 giây thay vì 11,7 giây.
Điều này đồng nghĩa với việc phát sinh thêm khoảng 49,3 giây xử lý trong tình huống thử nghiệm đó.
Vì vậy, hiệu quả KV Cache không chỉ phụ thuộc vào tốc độ truy xuất dữ liệu, mà còn phụ thuộc vào khả năng lưu giữ đủ dữ liệu để hạn chế Cache Miss.
Một hệ thống cache có dung lượng lớn và tỷ lệ truy xuất thành công cao có thể mang lại lợi ích đáng kể, ngay cả khi tầng lưu trữ dung lượng lớn không phải là công nghệ nhanh nhất.
Vì sao mở rộng dung lượng KV Cache là một thách thức?
Khi mô hình AI xử lý ngữ cảnh dài hơn và phục vụ nhiều người dùng đồng thời, lượng dữ liệu KV Cache cần lưu giữ cũng tăng lên.
Theo Western Digital, KV Cache truyền thống thường được đặt trong bộ nhớ băng thông cao của GPU (HBM), sau đó có thể mở rộng sang DRAM của máy chủ.
Những loại bộ nhớ này mang lại hiệu suất cao nhưng có giới hạn về dung lượng và chi phí mở rộng.
Để giải quyết bài toán đó, kiến trúc KV Cache có thể được thiết kế theo nhiều tầng.
Bốn tầng lưu trữ trong kiến trúc KV Cache
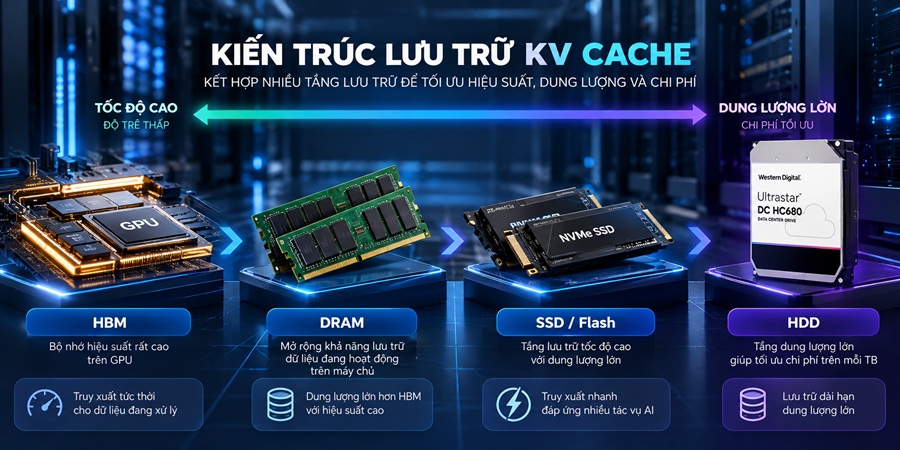
| Công nghệ | Vai trò |
|---|---|
| HBM | Bộ nhớ hiệu suất rất cao trên GPU, phục vụ dữ liệu cần truy xuất tức thời |
| DRAM | Mở rộng khả năng lưu trữ dữ liệu đang hoạt động trên máy chủ |
| SSD/Flash | Cung cấp tầng lưu trữ tốc độ cao với dung lượng lớn hơn bộ nhớ |
| HDD | Cung cấp dung lượng lưu trữ lớn, giúp tối ưu chi phí trên mỗi TB |
Trong mô hình này, mỗi tầng đảm nhận một vai trò khác nhau.
HBM và DRAM ưu tiên hiệu suất. SSD cung cấp khả năng truy xuất nhanh, trong khi HDD được sử dụng để mở rộng dung lượng với chi phí hợp lý hơn.
Việc kết hợp các tầng giúp hệ thống cân bằng giữa hiệu suất, dung lượng và ngân sách đầu tư.
HDD có đủ nhanh để phục vụ KV Cache trong AI không?
Thông thường, SSD được ưu tiên trong những ứng dụng cần độ trễ thấp vì có tốc độ truy xuất cao hơn HDD.
Tuy nhiên, Western Digital đặt ra một câu hỏi đáng chú ý:
Liệu dữ liệu KV Cache có nhất thiết phải được truy xuất với tốc độ nhanh nhất, hay chỉ cần đủ nhanh để tránh việc GPU phải tính toán lại?
Nếu việc đọc dữ liệu đã lưu từ HDD nhanh hơn đáng kể so với quá trình tính toán lại trên GPU, thì HDD vẫn có thể mang lại lợi ích cho hệ thống.
Tất nhiên, hiệu quả thực tế còn phụ thuộc vào kích thước dữ liệu, đặc điểm workload, khả năng truy xuất và cách tổ chức các tầng cache.
Do đó, HDD không được đề xuất để thay thế trực tiếp HBM, DRAM hay SSD trong mọi tác vụ AI.
Thay vào đó, HDD có thể trở thành tầng lưu trữ dung lượng lớn phía sau các tầng bộ nhớ và SSD tốc độ cao.
Thử nghiệm của Western Digital: HDD kết hợp SSD và DRAM mang lại kết quả gì?
Để đánh giá khả năng sử dụng HDD trong kiến trúc KV Cache, Western Digital thực hiện thử nghiệm được trình bày trong tài liệu kỹ thuật KV Cache Offload Across Storage Tiers: A Controlled Benchmark on an 8x NVIDIA B200 Inference Host.
Thử nghiệm sử dụng hệ thống AI với 8 GPU NVIDIA B200 và so sánh những cấu hình KV Cache khác nhau.
Các cấu hình bao gồm tầng lưu trữ chính bằng SSD hoặc HDD, kết hợp với một trong các phương án:
-
Không sử dụng tầng trung gian (staging tier).
-
Sử dụng 30 GiB DRAM trên máy chủ làm tầng trung gian.
-
Sử dụng SSD 15,36 TB trên máy chủ làm tầng trung gian.
Kết quả được đánh giá thông qua ba chỉ số:
Cache Hit Rate: Tỷ lệ dữ liệu được tìm thấy trong cache.
Time to First Token (TTFT): Thời gian để hệ thống tạo ra token đầu tiên.
Decode Tokens/Second: Số token được tạo ra mỗi giây trong giai đoạn giải mã.
Kết quả khi không sử dụng tầng trung gian
Trong cấu hình không có staging tier, SSD thể hiện hiệu suất tốt hơn HDD.
Cấu hình SSD đạt tỷ lệ Cache Hit cao hơn, thời gian tạo token đầu tiên thấp hơn và thông lượng giải mã tốt hơn.
Điều này phù hợp với lợi thế về tốc độ truy xuất của công nghệ flash.
Kết quả khi bổ sung DRAM hoặc SSD làm tầng trung gian
Khi bổ sung tầng trung gian bằng DRAM hoặc SSD, kết quả có sự thay đổi đáng chú ý.
Theo Western Digital, những cấu hình sử dụng HDD ở tầng dung lượng lớn có thể đạt kết quả tương đương cấu hình SSD trong cả ba chỉ số được thử nghiệm.
Các cấu hình có tầng trung gian cũng đạt kết quả tốt hơn các cấu hình không có tầng trung gian về TTFT và tốc độ giải mã token.
Kết quả cho thấy việc tổ chức kiến trúc lưu trữ có thể quan trọng không kém lựa chọn một loại thiết bị lưu trữ riêng lẻ.
Tuy nhiên, đây là kết quả trong môi trường thử nghiệm có kiểm soát. Hiệu suất khi triển khai thực tế cần được đánh giá theo workload, mô hình AI và cấu hình hệ thống cụ thể.
Lợi ích của HDD đối với chi phí hạ tầng AI
Một trong những lợi thế quan trọng của HDD là chi phí lưu trữ trên mỗi TB.
Theo phân tích của Western Digital, HDD có thể cung cấp dung lượng lớn với chi phí thấp hơn đáng kể so với các tầng lưu trữ flash.
Khi nhu cầu KV Cache tăng lên, sử dụng toàn bộ dung lượng bằng HBM, DRAM hoặc SSD có thể khiến ngân sách đầu tư trở nên rất lớn.
Bằng cách đưa dữ liệu ít cần truy xuất tức thời xuống tầng HDD, doanh nghiệp có thể mở rộng dung lượng cache mà không phải tăng tương ứng chi phí cho các công nghệ bộ nhớ hiệu suất cao.
Lợi ích của cách tiếp cận này bao gồm:
-
Mở rộng dung lượng KV Cache với chi phí hợp lý.
-
Tăng khả năng giữ lại dữ liệu ngữ cảnh đã được xử lý.
-
Giảm nguy cơ phải tính toán lại trên GPU khi dữ liệu còn trong cache.
-
Tối ưu việc phân bổ tài nguyên giữa bộ nhớ, SSD và HDD.
-
Hỗ trợ xây dựng hạ tầng AI có khả năng mở rộng.
Dù vậy, chi phí vận hành thực tế vẫn cần tính đến thiết bị, điện năng, làm mát, mạng và phần mềm quản lý dữ liệu.
Kiến trúc lưu trữ phân tầng là hướng tiếp cận đáng chú ý
Sự phát triển của AI Inference và Agentic AI đang đặt ra những yêu cầu mới đối với hạ tầng lưu trữ.
Khi ứng dụng AI cần duy trì ngữ cảnh dài hơn, xử lý nhiều tác vụ và phục vụ nhiều người dùng, dung lượng KV Cache có thể trở thành yếu tố ảnh hưởng lớn đến hiệu quả vận hành.
Theo kết quả thử nghiệm của Western Digital, kiến trúc kết hợp DRAM hoặc SSD ở tầng truy xuất nhanh với HDD ở tầng dung lượng lớn là một phương án đáng cân nhắc.
Thay vì lựa chọn giữa HDD và SSD, doanh nghiệp có thể khai thác thế mạnh của từng công nghệ để đạt sự cân bằng giữa tốc độ, dung lượng và chi phí.
WD Ultrastar và nhu cầu lưu trữ dung lượng lớn cho doanh nghiệp
Trong các hệ thống lưu trữ doanh nghiệp, những dòng HDD chuyên dụng cho trung tâm dữ liệu tiếp tục giữ vai trò quan trọng.
WD Ultrastar là dòng ổ cứng được thiết kế cho các môi trường lưu trữ doanh nghiệp và trung tâm dữ liệu, nơi cần dung lượng lớn, khả năng vận hành liên tục và khả năng mở rộng hệ thống.
Tùy từng model và cấu hình, WD Ultrastar có thể được triển khai trong hệ thống máy chủ, lưu trữ tập trung, kho dữ liệu phân tích và các tầng lưu trữ dung lượng lớn phục vụ hạ tầng AI.
Đối với ứng dụng KV Cache, việc lựa chọn ổ cứng cần được đánh giá ở cấp độ toàn hệ thống, bao gồm phần mềm quản lý cache, tầng SSD/DRAM, băng thông, độ trễ và đặc điểm truy xuất dữ liệu.
Kết luận
Trong hạ tầng AI, tốc độ lưu trữ không phải là yếu tố duy nhất quyết định hiệu quả vận hành.
KV Cache giúp mô hình AI tái sử dụng kết quả đã tính toán, giảm công việc lặp lại và cải thiện hiệu quả khai thác GPU. Để phát huy lợi ích này, hệ thống cần duy trì dung lượng cache phù hợp và tỷ lệ Cache Hit cao.
Các thử nghiệm của Western Digital cho thấy HDD, khi được kết hợp với DRAM hoặc SSD trong kiến trúc lưu trữ phân tầng, có thể hỗ trợ mở rộng KV Cache mà vẫn đáp ứng hiệu suất trong những điều kiện thử nghiệm cụ thể.
Thay vì chỉ đầu tư vào tốc độ, doanh nghiệp cần cân nhắc đồng thời dung lượng, hiệu suất truy xuất và chi phí lưu trữ để xây dựng hạ tầng AI hiệu quả.
Thiên An cung cấp các dòng ổ cứng Western Digital, bao gồm WD Ultrastar dành cho nhu cầu lưu trữ doanh nghiệp và trung tâm dữ liệu.
Nguồn tham khảo: Western Digital Blog
Xem bài viết khác
- Hybrid Storage là gì? Xu hướng kết hợp Cloud, NAS và HDD doanh nghiệp - 30-09-2026, 7:21 am
- Enterprise Storage là gì? Khi nào doanh nghiệp cần giải pháp lưu trữ chuyên dụng? - 10-09-2026, 9:51 pm
- Checklist chọn ổ cứng cho Server và NAS: 7 tiêu chí không nên bỏ qua - 18-08-2026, 2:22 pm
- Enterprise Storage là gì? Khi nào doanh nghiệp cần giải pháp lưu trữ chuyên dụng? - 04-08-2026, 8:12 pm
- SSD di động và HDD di động: Thiết bị nào đáng mua hơn? - 14-07-2026, 9:14 pm